
Cách Kiểm Tra Crawler Của AI Trên Website Chuẩn Xác [2026]
Nhiều quản trị viên mặc định rằng chỉ cần website cho phép Googlebot truy cập thì các nền tảng như ChatGPT, Perplexity hay Claude cũng tự động đọc được nội dung. Thực tế, các hệ thống AI vận hành những trình thu thập dữ liệu (AI crawler) độc lập và rất dễ bị tường lửa máy chủ chặn ngầm dù file robots.txt không hề cấm. Ngược lại, một số bot huấn luyện mô hình ngôn ngữ lại quét dữ liệu với tần suất dày đặc làm cạn kiệt tài nguyên hosting. Thực hiện kiểm tra AI crawler trên website ở cả cấp độ cấu hình lẫn nhật ký máy chủ (Server Log) giúp bạn biết chính xác con bot nào đang vào web, con bot nào bị chặn bởi mã lỗi 403, từ đó tối ưu khả năng xuất hiện của thương hiệu trên các công cụ tìm kiếm AI (GEO/AEO).
Cách Kiểm Tra Crawler Của AI Trên Website Chuẩn Xác [2026]
Phân biệt 3 nhóm AI Crawler cần nhận diện trước khi kiểm tra
Trước khi rà soát dữ liệu máy chủ, bạn cần phân biệt rõ chức năng của từng loại bot. Các công ty công nghệ như OpenAI, Anthropic hay Perplexity đều tách bạch bot thu thập dữ liệu huấn luyện (Training) và bot phục vụ tìm kiếm trực tiếp (Search). Nếu chặn nhầm nhóm bot tìm kiếm, website của bạn sẽ không thể xuất hiện trong phần trích dẫn nguồn (Citations) khi người dùng đặt câu hỏi trên AI.
| Nhóm AI Crawler | Tên User-Agent phổ biến | Đơn vị vận hành | Mục đích hoạt động | Khuyến nghị SEO/GEO |
| 1. AI Search Crawlers | OAI-SearchBot PerplexityBot Claude-SearchBot Applebot-Extended DuckAssistBot | OpenAI Perplexity AI Anthropic Apple DuckDuckGo | Thu thập và lập chỉ mục nội dung để hiển thị kết quả trả lời kèm link trích dẫn trực tiếp trên các công cụ AI Search. | Nên mở (Allow) để tăng hiển thị thương hiệu và kéo traffic tự nhiên. |
| 2. AI Training Crawlers | GPTBot ClaudeBot Google-Extended Meta-ExternalAgent CCBot Bytespider | OpenAI Anthropic Meta Common Crawl ByteDance | Quét dữ liệu diện rộng để đưa vào tập dữ liệu huấn luyện các mô hình ngôn ngữ lớn (LLM) thế hệ tiếp theo. | Mở có chọn lọc hoặc chặn các bot tốn băng thông nhưng không mang lại khách hàng (như Bytespider, CCBot). |
| 3. User-Triggered Fetchers | ChatGPT-User Claude-User Perplexity-User | OpenAI Anthropic Perplexity AI | Truy cập vào một URL cụ thể ngay tại thời điểm người dùng dán link hoặc yêu cầu AI tóm tắt trang web đó. | Nên mở (Allow) để AI đọc được thông tin sản phẩm/dịch vụ khi khách hàng tra cứu trực tiếp. |
Một điểm kỹ thuật cần lưu ý: Google-Extended không phải là trình thu thập dữ liệu độc lập đi quét web riêng lẻ, mà là một thẻ điều khiển trong robots.txt giúp quản trị viên cho phép hoặc từ chối việc Google sử dụng dữ liệu đã quét (qua Googlebot) để huấn luyện hệ sinh thái Gemini AI.
5 Cách kiểm tra crawler của AI trên website từ cơ bản đến chuyên sâu
Một quy trình kiểm tra tiêu chuẩn không chỉ dừng lại ở việc xem file robots.txt khai báo gì, mà phải xác minh được trạng thái phản hồi thực tế của máy chủ và lịch sử truy cập trong file Log. Dưới đây là 5 phương pháp kiểm tra từ nhanh đến chuyên sâu.
Cách 1: Kiểm tra quyền truy cập qua file robots.txt và công cụ Online
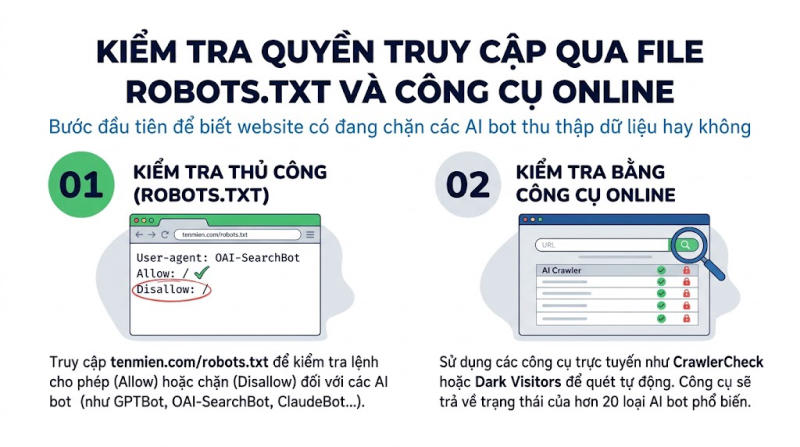
Đây là bước đầu tiên để kiểm tra xem website có đang vô tình đặt lệnh Disallow đối với các AI bot trong tệp cấu hình hay không.
Kiểm tra quyền truy cập qua file robots.txt và công cụ Online
Kiểm tra thủ công:
- Truy cập đường dẫn [https://tenmien.com/robots.txt](https://tenmien.com/robots.txt) trên trình duyệt.
- Nhấn tổ hợp phím Ctrl + F và tìm kiếm tên các User-Agent như GPTBot, OAI-SearchBot, ClaudeBot, PerplexityBot hoặc User-agent: *.
- Kiểm tra chỉ thị đi kèm bên dưới:
- Nếu hiển thị Disallow: / nghĩa là toàn bộ website đang từ chối con bot đó.
- Nếu hiển thị Allow: / hoặc chỉ chặn các thư mục quản trị (/wp-admin/, /cart/) thì bot vẫn được phép thu thập nội dung công khai.
Kiểm tra bằng công cụ tự động (AI Crawler Checker): Ngoài file robots.txt, quyền truy cập của bot còn bị chi phối bởi thẻ <meta name="robots"> trong mã HTML hoặc tiêu đề phản hồi HTTP X-Robots-Tag (ví dụ: thẻ noai hoặc noimageai). Bạn có thể sử dụng các công cụ trực tuyến miễn phí như CrawlerCheck hoặc Dark Visitors để nhập URL và quét tự động. Công cụ sẽ trả về bảng trạng thái cho phép/bị chặn của hơn 20 loại AI crawler phổ biến chỉ sau vài giây.
Cách 2: Phân tích Server Access Log để biết chính xác AI nào đã vào web
Kiểm tra robots.txt chỉ cho bạn biết "luật lệ" bạn đặt ra trên web, còn Server Access Log (Nhật ký truy cập máy chủ) mới là bằng chứng xác thực 100% con bot nào đã thực sự vào website, vào những URL nào, tần suất bao nhiêu lần/ngày và máy chủ trả về mã trạng thái gì.
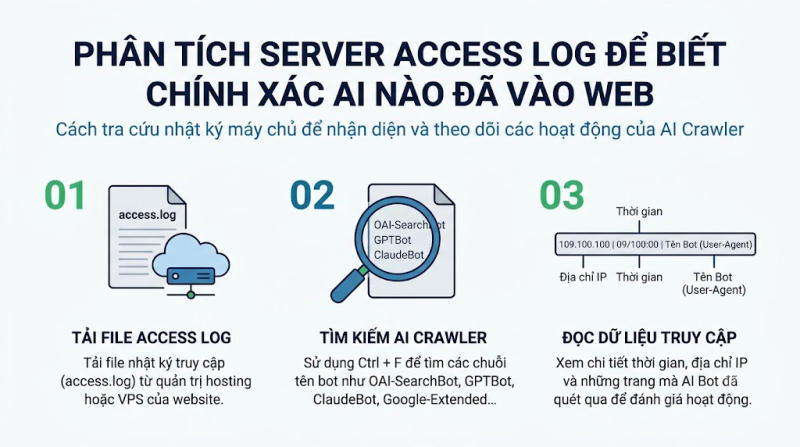
Phân tích Server Access Log để biết chính xác AI nào đã vào web
Bước 1: Trích xuất file Access Log từ máy chủ
- Trên cPanel: Đăng nhập cPanel → mục Metrics → chọn Raw Access → tải file nén .gz của tên miền về máy tính.
- Trên DirectAdmin: Vào mục System Info & Files → Site Summary / Statistics / Logs → chọn Usage Log.
- Trên VPS (Nginx / Apache): File log thường nằm tại đường dẫn /var/log/nginx/access.log (đối với Nginx) hoặc /var/log/apache2/access.log (đối với Apache).
Bước 2: Lọc dữ liệu AI Crawler bằng dòng lệnh hoặc phần mềm
Nếu có quyền truy cập SSH vào VPS hoặc dùng Terminal trên máy tính, bạn có thể chạy câu lệnh grep sau để lọc toàn bộ lượt truy cập của các AI bot phổ biến:
Bash
grep -E "GPTBot|OAI-SearchBot|ChatGPT-User|ClaudeBot|Claude-SearchBot|PerplexityBot|Meta-ExternalAgent|Bytespider|CCBot" /var/log/nginx/access.log > ai-bots.log
Nếu bạn muốn thống kê nhanh số lượt quét của từng loại bot để xem con bot nào đang tiêu tốn nhiều tài nguyên nhất, hãy sử dụng lệnh:
Bash
grep -oE "GPTBot|OAI-SearchBot|ChatGPT-User|ClaudeBot|PerplexityBot|Meta-ExternalAgent|Bytespider|CCBot" /var/log/nginx/access.log | sort | uniq -c | sort -nr
Trong trường hợp không rành dòng lệnh, bạn hãy tải file log về máy và mở bằng phần mềm Screaming Frog Log File Analyser. Tại thanh tìm kiếm User-Agent, nhập biểu thức chính quy (Regex) bên dưới để lọc riêng các dòng log của AI:
Plaintext
(GPTBot|OAI-SearchBot|ChatGPT-User|ClaudeBot|Claude-SearchBot|PerplexityBot|Meta-ExternalAgent|Bytespider)
Bước 3: Đọc hiểu thông số trong dòng Log
Một dòng log điển hình của OpenAI sẽ có định dạng như sau:
Plaintext
20.171.206.10 - - [27/Oct/2026:08:15:22 +0700] "GET /dich-vu-seo-da-nang/ HTTP/2.0" 200 18452 "-" "Mozilla/5.0 AppleWebKit/537.36 (KHTML, like Gecko); compatible; OAI-SearchBot/1.0; +https://openai.com/searchbot"
- Địa chỉ IP: 20.171.206.10
- Đường dẫn được quét: /dich-vu-seo-da-nang/
- Mã trạng thái HTTP (200): Máy chủ phản hồi thành công, bot đọc được toàn bộ nội dung. Nếu chỗ này hiển thị 403 (Forbidden) hoặc 429 (Too Many Requests), nghĩa là tường lửa đang chặn bot.
Lưu ý kỹ thuật: Nếu website sử dụng dịch vụ CDN (như Cloudflare) và bật chế độ lưu bộ nhớ đệm (Cache) cho cả trang HTML, các lượt truy cập của AI bot có thể được trả về trực tiếp từ máy chủ CDN mà không chạm tới máy chủ gốc (Origin Server). Khi đó, bạn cần kết hợp kiểm tra theo Cách 3.
Cách 3: Kiểm tra trực tiếp trên Cloudflare (AI Crawl Control)
Đối với các website đang trỏ DNS và bật đám mây cam (Proxy) qua Cloudflare, bạn không cần tải file log thủ công mà có thể theo dõi trực tiếp qua tính năng AI Crawl Control (trước đây là AI Audit) được tích hợp sẵn.
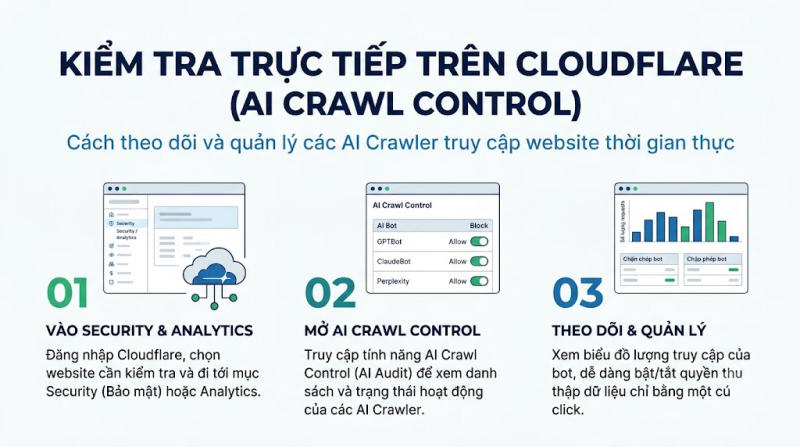
Kiểm tra trực tiếp trên Cloudflare (AI Crawl Control)
Quy trình kiểm tra trên giao diện Cloudflare:
- Đăng nhập vào tài khoản Cloudflare và chọn tên miền cần kiểm tra.
- Tại thanh menu bên trái, chọn mục AI Crawl Control (hoặc truy cập vào Security → Analytics).
- Mở tab Crawlers để xem bảng thống kê chi tiết:
- Tổng số lượng request từ các trình thu thập AI theo khung thời gian (24 giờ, 7 ngày, 30 ngày).
- Danh sách cụ thể từng bot (GPTBot, ClaudeBot, Meta-ExternalAgent, Bytespider, Amazonbot...) kèm số lượng lượt truy cập thành công (Allowed) và số lượt bị chặn (Blocked).
- Chuyển sang tab Metrics để xem danh sách các URL hoặc đường dẫn (Path) trên website được AI quét nhiều nhất. Từ dữ liệu này, bạn sẽ biết ngay các bài viết chiến lược hay trang dịch vụ trọng tâm của mình đã được AI thu thập hay chưa.
Cách 4: Giả lập User-Agent bằng lệnh cURL để kiểm tra phản hồi của Server
Rất nhiều trường hợp file robots.txt hoàn toàn không chặn AI, nhưng khi kiểm tra thì bài viết vẫn không bao giờ được trích dẫn trên ChatGPT hay Perplexity. Nguyên nhân phổ biến là do nhà cung cấp Hosting (Imunify360, ModSecurity) hoặc plugin bảo mật (Wordfence) tự động nhận diện User-Agent của AI là bot tấn công và trả về mã lỗi 403 Forbidden.
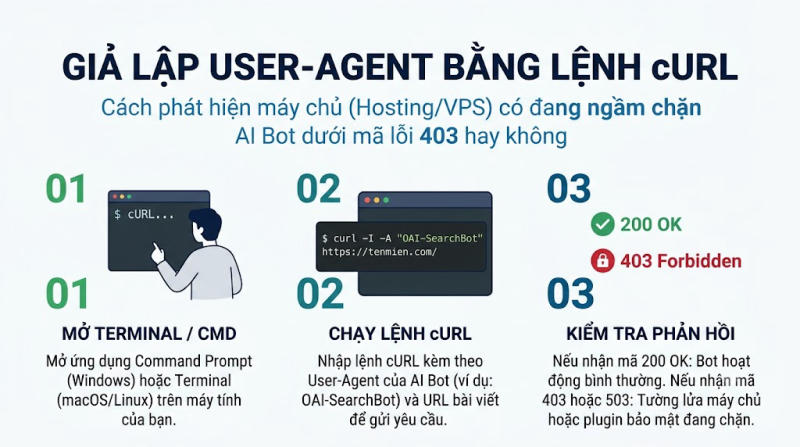
Giả lập User-Agent bằng lệnh cURL để kiểm tra phản hồi của Server
Để kiểm tra xem máy chủ của bạn phản hồi như thế nào khi một AI Crawler gõ cửa, hãy mở Terminal (trên macOS/Linux) hoặc Command Prompt / PowerShell (trên Windows) và chạy câu lệnh cURL giả lập sau:
Kiểm tra với OAI-SearchBot (Bot tìm kiếm của ChatGPT):
Bash
curl -I -A "Mozilla/5.0 AppleWebKit/537.36 (KHTML, like Gecko); compatible; OAI-SearchBot/1.0; +https://openai.com/searchbot" https://tenmien.com/
Kiểm tra với PerplexityBot:
Bash
curl -I -A "Mozilla/5.0 AppleWebKit/537.36 (KHTML, like Gecko; compatible; PerplexityBot/1.0; +https://perplexity.ai/perplexitybot)" https://tenmien.com/
Kiểm tra với ClaudeBot:
Bash
curl -I -A "Mozilla/5.0 AppleWebKit/537.36 (KHTML, like Gecko; compatible; ClaudeBot/1.0; +claudebot@anthropic.com)" https://tenmien.com/
Cách đọc kết quả trả về:
- Nếu dòng đầu tiên trả về HTTP/2 200 (hoặc HTTP/1.1 200 OK): Máy chủ cho phép AI bot truy cập bình thường.
- Nếu trả về HTTP/2 403 hoặc HTTP/2 503: Tường lửa máy chủ hoặc CDN đang chặn chuỗi User-Agent này. Bạn cần vào phần cài đặt WAF (Web Application Firewall) để đưa các bot này vào danh sách cho phép (Whitelist/Skip Rule).
- Ngoài ra, hãy quan sát xem trong phần Header trả về có dòng X-Robots-Tag: noai hay X-Robots-Tag: noindex hay không. Nếu có, dù mã trạng thái là 200, bot vẫn sẽ bỏ qua nội dung theo giao thức tuân thủ bản quyền.
Cách 5: Xác thực AI Crawler thật hay Bot giả mạo qua Reverse DNS và IP
Chuỗi định danh User-Agent rất dễ bị làm giả. Nhiều công cụ cào nội dung tự động (Scraper) của đối thủ hoặc hệ thống spam thường đổi tên thành GPTBot hoặc Googlebot để vượt qua bộ lọc bảo mật của bạn. Do đó, khi thấy một IP có lượng truy cập bất thường trong file Log tự xưng là AI Crawler, bạn cần xác minh danh tính thật của nó.
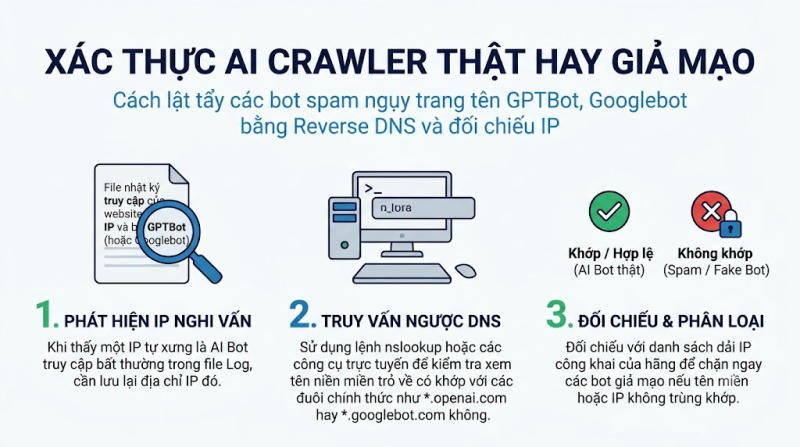
Xác thực AI Crawler thật hay Bot giả mạo qua Reverse DNS và IP
Phương pháp 1: Đối chiếu dải IP công bố chính thức (IP Ranges JSON)
Các hãng AI lớn không phải lúc nào cũng thiết lập Reverse DNS cho mọi IP, nhưng họ cung cấp danh sách địa chỉ IP chính thức dưới dạng file JSON được cập nhật liên tục:
- OpenAI (GPTBot): [https://openai.com/gptbot.json](https://openai.com/gptbot.json)
- OpenAI (OAI-SearchBot): [https://openai.com/searchbot.json](https://openai.com/searchbot.json)
- OpenAI (ChatGPT-User): [https://openai.com/chatgpt-user.json](https://openai.com/chatgpt-user.json)
- Perplexity (PerplexityBot): [https://www.perplexity.ai/perplexitybot.json](https://www.perplexity.ai/perplexitybot.json)
- Google (Googlebot / Google-Extended): [https://developers.google.com/static/search/apis/ipranges/googlebot.json](https://developers.google.com/static/search/apis/ipranges/googlebot.json)
Bạn chỉ cần lấy địa chỉ IP xuất hiện trong file Log và tra cứu xem nó có nằm trong các dải subnet (CIDR) được liệt kê trong các file JSON trên hay không.
Phương pháp 2: Tra cứu ngược DNS (Reverse DNS Lookup)
Đối với các bot hỗ trợ xác thực qua tên miền ngược (như bot của Google hoặc Apple), bạn có thể kiểm tra bằng lệnh host trên Terminal:
Bash
host 66.249.66.1
Nếu kết quả trả về có đuôi *.googlebot.com, *.google.com hoặc *.applebot.apple.com, sau đó bạn chạy lệnh host ngược lại tên miền đó mà trùng khớp với IP ban đầu thì đó là bot thật 100%. Nếu trả về tên miền của các dịch vụ thuê VPS giá rẻ (như DigitalOcean, Vultr, Hetzner, OVH...) trong khi User-Agent lại khai báo là Googlebot, chắc chắn đó là bot giả mạo cần chặn ngay lập tức.
Cách xử lý sau khi kiểm tra: Nên chặn hay mở AI Crawler để tối ưu SEO & GEO?
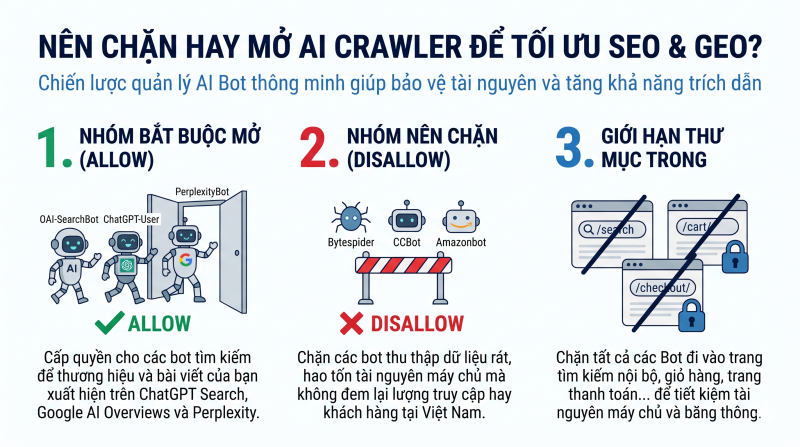
Sau khi nắm được danh sách các AI crawler đang truy cập vào website, bạn không nên mở toang toàn bộ hoặc chặn tất cả một cách cực đoan. Chiến lược tối ưu nhất là mở đường cho các bot mang lại hiển thị thương hiệu (GEO) và chặn các bot tiêu tốn tài nguyên vô ích.
Cách xử lý sau khi kiểm tra: Nên chặn hay mở AI Crawler để tối ưu SEO & GEO?
- Nhóm bắt buộc phải MỞ (Allow): Mở toàn bộ quyền truy cập (và Whitelist trên tường lửa nếu bị chặn) cho OAI-SearchBot, ChatGPT-User, PerplexityBot, Claude-SearchBot, Googlebot và Google-Extended. Đây là cầu nối trực tiếp giúp bài viết, sản phẩm và thương hiệu của bạn xuất hiện trong câu trả lời của ChatGPT, Google AI Overview và Perplexity.
- Nhóm nên CHẶN (Disallow / Block WAF): Chặn các trình thu thập dữ liệu cào quá rát nhưng không phục vụ thị trường khách hàng tại Việt Nam như Bytespider (ByteDance), CCBot (Common Crawl), hoặc các bot chuyên cào dữ liệu thương mại điện tử như Amazonbot (nếu web của bạn không liên quan đến hệ sinh thái Amazon).
- Nhóm thư mục cần giới hạn: Ngay cả với các bot được phép truy cập, bạn vẫn nên chặn chúng đi vào các trang tìm kiếm nội bộ (/search, ?s=), trang giỏ hàng (/cart/, /checkout/) hoặc các URL chứa tham số lọc (?filter=, ?sort=) để tránh lãng phí ngân sách thu thập (Crawl Budget) và giảm tải cho CPU máy chủ.
Mẫu cấu hình robots.txt chuẩn cho SEO & GEO:
Plaintext
# Cho phép các bot tìm kiếm truyền thống và AI Search (GEO/AEO)
User-agent: Googlebot
User-agent: Google-Extended
User-agent: OAI-SearchBot
User-agent: ChatGPT-User
User-agent: PerplexityBot
User-agent: Claude-SearchBot
User-agent: Applebot-Extended
Allow: /
Disallow: /wp-admin/
Disallow: /cart/
Disallow: /*?s=
Disallow: /search/
# Chặn các bot cào dữ liệu diện rộng gây tốn băng thông
User-agent: Bytespider
User-agent: CCBot
Disallow: /
Câu hỏi thường gặp khi kiểm tra AI Crawler
Dưới đây là giải đáp cho những thắc mắc phổ biến nhất khi đối chiếu dữ liệu thống kê và phân quyền cho AI bot trên website:
1. Tại sao không thấy lượt truy cập của AI Crawler trong Google Analytics 4 (GA4)?
Đa số các trình thu thập dữ liệu của AI (như GPTBot, ClaudeBot, PerplexityBot) chỉ tải mã nguồn HTML thô của trang web và không thực thi mã JavaScript của thẻ theo dõi GA4. Do đó, mọi lượt bot vào quét dữ liệu sẽ không hiển thị trong báo cáo của GA4. GA4 chỉ ghi nhận dữ liệu (thường nằm ở kênh Referral với nguồn là chatgpt.com hoặc perplexity.ai) khi có một người dùng thật sự nhấp vào đường link trích dẫn trên giao diện AI để truy cập vào website của bạn.
2. Chặn GPTBot nhưng mở OAI-SearchBot có ảnh hưởng đến khả năng hiển thị trên ChatGPT không?
Không ảnh hưởng. OpenAI đã tách biệt hoàn toàn chức năng của hai trình thu thập này. Khi bạn chặn GPTBot và mở OAI-SearchBot, nội dung trên website của bạn sẽ không bị lấy để huấn luyện các mô hình GPT trả phí trong tương lai, nhưng vẫn được lập chỉ mục và trích dẫn nguồn bình thường khi người dùng sử dụng tính năng tìm kiếm trực tuyến trên ChatGPT.
Kiểm tra và cấu hình đúng luồng truy cập cho AI Crawler là bước nền tảng để website không bị mất dấu trên các công cụ tìm kiếm thế hệ mới. Nếu website của bạn đang gặp tình trạng tụt giảm lưu lượng truy cập chưa rõ nguyên nhân, máy chủ quá tải do bot quét, hoặc chưa xuất hiện trong các câu trả lời của ChatGPT, Gemini và Google AI Overview, đội ngũ kỹ thuật tại SEOViP sẵn sàng hỗ trợ bạn rà soát toàn diện.
Thông qua dịch vụ Audit Website 72h và Dịch vụ SEO Tổng thể tích hợp AI/GEO, SEOViP giúp doanh nghiệp kiểm tra chuyên sâu từ tầng Server Log, tối ưu cấu trúc dữ liệu chuẩn thực thể (Entity) cho đến việc gia tăng tỷ lệ chuyển đổi đơn hàng thực tế.
Thông tin liên hệ tư vấn kỹ thuật tại SEOViP:
================================
CÔNG TY TNHH TRUYỀN THÔNG & THƯƠNG MẠI SEOVIP
- A : 181 Nguyễn Tri Phương, Đà Nẵng
- M : 0934.52.6656 - 0971.72.6656 - Ms.Phương
- E : info@seovip.vn
- W : www.SEOViP.vn
- F : https://www.facebook.com/SEOViPDaNang/


“Hiện là CEO & Founder SEOViP Digital Agency & SEOViP Academy. Thanh học CNTT, đam mê internet Marketing, kiếm tiền Online. Với hơn +13 năm gắn bó với nghề SEO, triển khai 250+ dự án SEO 1.000+ website 1500+ học viên đã áp dụng & thành công dù tuổi đời còn rất trẻ. Thích đọc, viết, làm và chia sẻ những kiến thức SEO/SEM, kỹ năng bán hàng, kinh doanh trực tuyến để Bạn có thể tự làm SEO, Marketing và kiếm tiền…Giúp Thanh nếu Bạn biết ai đang cần tư vấn SEO miễn phí, cố vấn SEO Mentor phát triển kinh doanh trên internet hay tìm SEO Agency uy tín hiệu quả Với chi phí tiết kiệm thì giới thiệu Thanh nhé. Cảm ơn Bạn nhiều…